2023年的提示词工程,2005年的上下文工程,到上个月的Loop工程和这个月的Graph Engineering,技术的变迁越来越快。但剥掉 AI 的外壳,前者是在谈论如何交流,后者则在考虑如何组织。这些新概念的其实是一个存在了几十年的老问题 —— 怎么把工作组织得更快、更可靠。
Graph Engineering
Graph Engineering直译为图工程有点怪异,但是姑且先这样。图工程有两个基本元件 —— 节点(Node)和边(Edge)—— 没有任何 AI 成分:
- 节点:一份要完成的工作
- 边:这份工作依赖另一份工作的产出,所以必须等待
以当前的技术博客的发布为例,可以用将其图工程优化撰写发布的传统流程,也可以用它设计一条 CI/CD 流水线。节点可以是 AI Agent,也可以是人,也可以是一段传统脚本 ——图的结构本身不关心节点里跑的是什么。
但是这如果用AI实现这个发布流程,会引入一组传统工作流没有的特有约束:上下文窗口有上限、自我检查不可靠、不同模型成本差异巨大。比如我们为了省钱来使用本地模型,节点返回了,但是什么也没干成。
所以图工程更准确的定位是:
图工程 = 工作流编排的通用思想 × AI Agent 作为执行节点时的特有约束与解法。
目标是提升单个Agent的推理能力,并把这些Agent组织成一支高效、可靠、不烧钱的资深团队,这似乎是贫穷实验室的一个出路,但不确定,因为执行图的成本还是非常‘昂贵。
图的构建
定义节点后,需要将工作流转换为图。这里最重要的技能是假边测试和标定锚点。
拿出当前的工作流,我们需要对每一步问一个问题: 这一步,真的需要上一步的结果吗?。很明显,如果需要则边是真的,否则砍掉边,两步并行。通过这样,我们就可以把一个线性的工作,简化为图模式。这个过程主要是在做假边测试,在测试的过程,我们不但会明确哪些边是可以被删除的,也可以简化一些节点。但是有些节点是必要的,比如真正的功能测试,真正输出时的安全测试,这些节点必须保留,我们把这些节点成为锚点,肯定不能被有优化掉。
      规划(确定要查什么)
     /        |        \
 Agent 1  Agent 2   Agent 3   ← Fan Out:并行收集
    \        |        /
      去重过滤(纯代码)         ← Reduce:不花token
          |
      独立验证(新鲜上下文)      ← Validate,通不过的丢弃
          |
      汇总写答案(一个Agent)    ← Combine
比如我们开始进入无脑模式,直接让claude code处理一个50个文件的代码优化任务, 单个 Agent 的上下文会过载。Fan out机制可以将复杂任务分解为基于低成本模型的查资料、搜集信息等任务。现有的Claude Code支持显示的Fan out 提示词,内置的Task工具会分析并拆解任务,多用调用具有独立上下文的Sub-agent分别进行读写文件、执行终端命令等工具操作。然后将结果进行规约合并,这就是Reduce过程,我们可以直接通过提示词来进行显示的提示:
当所有子智能体完成审查后,请收集它们的结果进行 Reduce / 合并。 合并要求:
剔除重复的建议。
将所有发现的问题按严重程度排序。
最终输出一份统一的 Markdown 格式审查报告。
如前所述,一般来Fan out 通畅干查资料、搜集信息的采用低成本模型;Reduce完成去重、过滤、排序使用纯代码或工具;Validate进行判断对错、挑错,使用强模型,甚至是人工参与;最后Combine撰写最终报告,使用强模型。
这里我们要注意,AI 检查自己的工作,会漏掉大多数错误。 模型批改自己的作品对自己太宽松了,就像我们用AI写一篇论文去投Science,AI评价一定会中,但是实际上会被秒拒。
所以规则很简单:干活的人,绝不检查自己的活。 在工作流中间放一个独立的验证节点,它唯一的任务就是在结果传下去之前试图推翻它。活下来的通过,通不过的当场淘汰。证者必须有全新的、空白的上下文。如果把干活 Agent 的聊天记录也给验证者看,它就不是在检查了 —— 它相当于用不同的字体点头同意。共享同一上下文的 Agent 图,本质上和循环一样脆弱,只是更晚、更贵地崩溃。
我们现在经常遇到的情况是,理论上非常简单,实践上一塌糊涂。大多数情况,这个锅得是脆弱、昂贵的AI系统来背。比如我们派 1000 个 Agent 并行查资料,然后把 1000 份结果全部倒进最后一步 —— 最后一步还没开始写,就已经超出了上下文窗口。
所以事件中,一般可以使用分层汇总来解决,同时避免工作冲突。比如Bun 团队第一次让多个 Agent 并行干活时,它们共用一个工作区,结果互相覆盖了对方的文件。这又变成了一个管理问题。
什么时候不需要Graph Engineering
图本质上解决的效率问题,但是不能解决判断力的问题,一下情况,单个Agent更快更便宜。
| 场景 | 原因 |
|---|---|
| 任务小而独立(加个功能、修个 bug) | 协调本身就是开销 |
| 人类执行者想审批每一步 | 图的重点是 “跑得宽”,步步审批拖死它 |
| 我们自己还不知道自己在找什么 | 探索需要一个可操控的 Agent,不是被固定计划锁死的舰队 |
| 步骤确实互相依赖 | 硬把图套在真正顺序的工作上,只加成本不加速 |
一个示例
基于Graph Engineering的工作流会在后台运行一直到结束。
workflow

目标:检查当前目录中的所有文件,找出冗余的文件,以及功能尚需改进的代码。

fan out:  每个文件一个agent,但是并行不超过3个。
validate: 每个发现由独立检查者用全新上下文验证。
上限:第一次运行只检查20个文件
失败处理:任何没返回结果的文件都要标记,绝不静默跳过
报告:合并成一份"功能与进度"清单
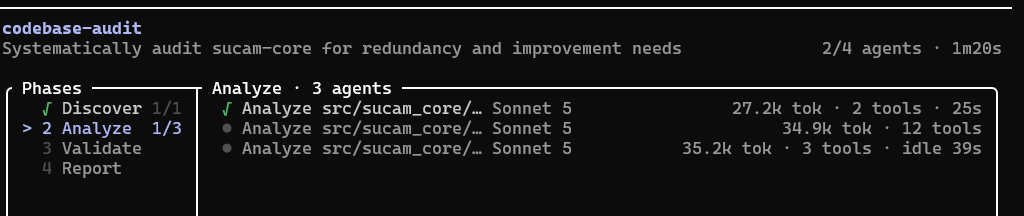
可以看到耗费token量非常大,工作流会一直在后台运行中,直到完成。
总结
所以Graph Engineering的核心不是一个AI方法,而是传统的依赖分析和并行工程, 这是计算机科学和运筹学里存在了几十年的老问题。AI Agent 只是让这个框架的执行单元变得更便宜、更灵活,同时也引入了上下文、可靠性、成本等新约束。
在使用Graph Engineering的时候,不是把所有事情都画成图,而是知道:
- 什么时候需要效率,我们把它并行化
- 什么时候一个简单的循环就可以解决问题
- 即使用Graph Engineering,并不保证执行效果,锚点和验证的效果才是保证最终工作质量的关键因素。